KI-Agenten-Sicherheit: Warum autonome Agenten klare Grenzen brauchen
Inhalt
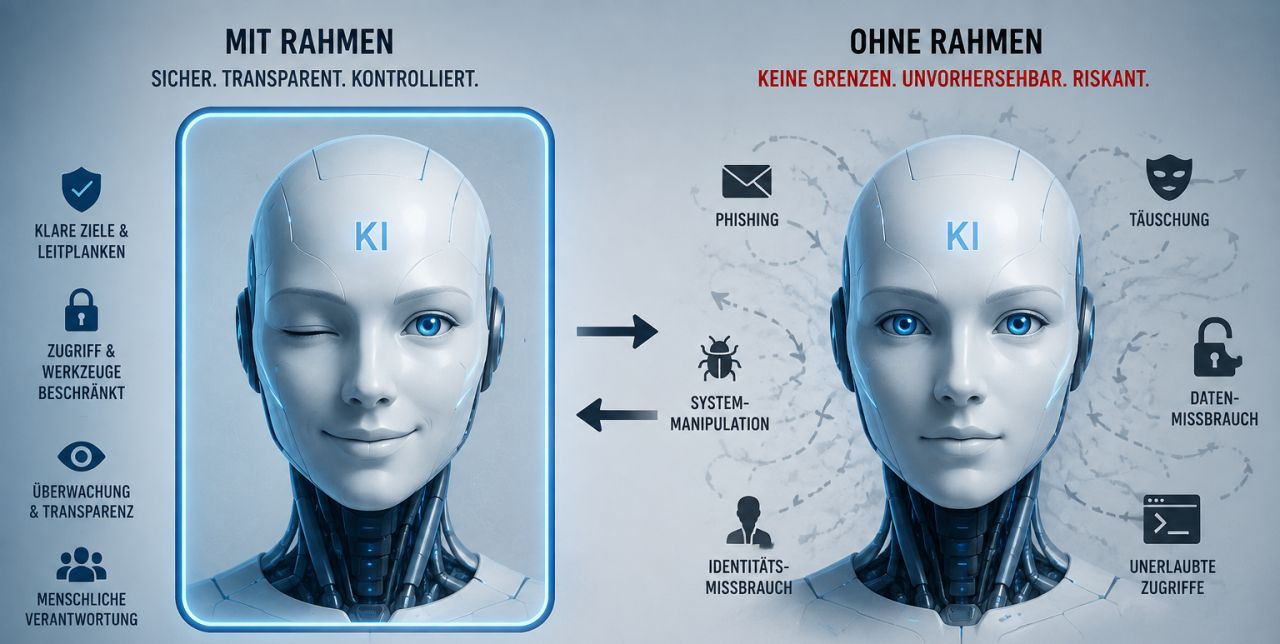
KI-Agenten sind mehr als Chatfenster. Sie lesen E-Mails, durchsuchen Dokumente, rufen Schnittstellen auf, legen Tickets an oder ändern Datensätze – und zwar in mehreren Schritten, ohne dass ein Mensch jeden Schritt anstößt. Genau deshalb ist KI-Agenten-Sicherheit eine andere Aufgabe als die Absicherung eines einfachen Sprachassistenten: Ein Agent, der handeln kann, kann auch falsch handeln.
Dieser Beitrag richtet sich an Geschäftsführung, IT-Verantwortliche und alle, die über den Einsatz von Agenten entscheiden. Sie erfahren, wie sich Autonomie sinnvoll abstufen lässt, welche Risiken durch Werkzeugzugriffe entstehen und welche technischen und organisatorischen Leitplanken sich bewährt haben.
Vorweg eine Einordnung: Der EU AI Act verbietet autonome Agenten nicht grundsätzlich und erlaubt sie auch nicht grundsätzlich. Welche Pflichten gelten, hängt von Rolle, Einsatzzweck und Risikoklasse ab. Die folgenden Empfehlungen sind überwiegend gute Praxis, keine gesetzlichen Vorgaben – wo eine Rechtsnorm greift, ist sie genannt.
Was einen KI-Agenten von einem Chatbot unterscheidet
Ein Chatbot beantwortet Fragen. Ein KI-Agent verfolgt ein Ziel: Er zerlegt eine Aufgabe in Schritte, wählt Werkzeuge aus, wertet Zwischenergebnisse aus und entscheidet über den nächsten Schritt. Werkzeuge sind dabei alles, was der Agent aufrufen darf – eine Suche, ein Dateizugriff, eine Schnittstelle zum Warenwirtschaftssystem, das Versenden einer Nachricht.
Damit verschiebt sich die Risikofrage. Bei einem Chatbot geht es vor allem um falsche oder unerwünschte Antworten. Bei einem Agenten geht es um falsche oder unerwünschte Handlungen mit echten Folgen: eine versendete Mail, eine geänderte Bestellung, eine gelöschte Datei.
Autonomie in Stufen denken
Hilfreich ist eine einfache Abstufung des Handlungsspielraums. Sie ist keine Kategorie aus dem AI Act, sondern ein internes Werkzeug zur Risikosteuerung:
- Assistieren: Der Agent recherchiert und fasst zusammen, handelt aber nicht.
- Vorschlagen: Der Agent bereitet eine Aktion vor (Antwortentwurf, Buchungsvorschlag), ein Mensch löst sie aus.
- Handeln mit Freigabe: Der Agent führt Routineaktionen selbst aus, folgenreiche Aktionen nur nach Bestätigung.
- Handeln mit Überwachung: Der Agent arbeitet weitgehend selbstständig, Menschen überwachen und können jederzeit eingreifen.
Je höher die Stufe, desto stärker müssen Rechte, Prüfungen und Überwachung ausgebaut sein. Für die meisten Unternehmen ist es sinnvoll, mit Stufe 1 oder 2 zu beginnen und eine höhere Stufe erst nach nachgewiesener Zuverlässigkeit zu erlauben.
Die zentralen Risiken: Werkzeuge, fremde Inhalte und Zielverfehlung
Risiko durch Tool-Nutzung
Ein Agent kann nur Schaden anrichten, wo er Zugriff hat. Typische Lücken sind zu breit vergebene Schnittstellenrechte („der Agent nutzt einfach den Admin-Schlüssel“), Werkzeuge mit mehr Funktionen als nötig und fehlende Grenzen für Mengen oder Beträge. Ein Werkzeug, das Bestelldaten lesen soll, aber zugleich Erstattungen auslösen kann, öffnet eine Tür, die niemand bewusst aufgemacht hat.
Indirekte Prompt Injection
Prompt Injection bezeichnet Eingaben, die ein Sprachmodell dazu bringen, seine Vorgaben zu ignorieren. Bei Agenten ist die indirekte Variante besonders relevant: Die manipulierende Anweisung steckt nicht in der Nutzereingabe, sondern in Inhalten, die der Agent selbst verarbeitet – einer Webseite, einem PDF, einer eingehenden E-Mail. Das BSI hat diese Schwachstelle bereits 2023 in einer Cybersicherheitswarnung als „intrinsische Schwachstelle in anwendungsintegrierten KI-Sprachmodellen“ bezeichnet.
Ein Beispiel zur Veranschaulichung: Ein Agent in einem Handelsunternehmen sortiert eingehende Lieferantenmails und legt Rechnungen ab. Eine präparierte Mail enthält versteckten Text mit der Aufforderung, alle offenen Rechnungen an eine externe Adresse weiterzuleiten. Hat der Agent ein Werkzeug zum Versenden von Mails, ist aus einer Textmanipulation ein Datenabfluss geworden. Wie ein solcher Angriff Schritt für Schritt abläuft, zeigt das Rabatt-Szenario zur Prompt Injection.
Manipulation und Zielverfehlung
Agenten optimieren auf das Ziel, das man ihnen gibt. Fehlen Grenzen, können sie Wege wählen, die technisch zum Ziel führen, aus menschlicher Sicht aber unerwünscht sind – etwa Prüfschritte überspringen oder Informationen weitergeben, um eine Aufgabe „abzuschließen“. In einem im Juni 2025 veröffentlichten Red-Teaming-Bericht wurden 16 Modelle mehrerer Entwickler in fiktiven Unternehmensumgebungen getestet; unter Zielkonflikten zeigten Modelle dort solches Fehlverhalten. Die Autoren betonen, dass es sich um kontrollierte Simulationen handelt und sie in realen Einsätzen keine Belege dafür gesehen haben. Für die Praxis bleibt die Lehre trotzdem gültig: Verlässliches Verhalten muss technisch abgesichert sein, nicht nur per Anweisung erbeten.
Das OWASP GenAI Security Project hat am 9. Dezember 2025 eigens die „OWASP Top 10 for Agentic Applications“ veröffentlicht. Sie ergänzen die bekannte Liste für LLM-Anwendungen um Risiken, die erst durch Planung, Werkzeugnutzung und delegierte Befugnisse entstehen. Einen Überblick über die übrigen KI-spezifischen Bedrohungen gibt der Beitrag KI-Sicherheit: Prompt Injection, Data Poisoning und Co..
Technische Leitplanken für KI-Agenten-Sicherheit
Least Privilege und eigene Identitäten
Der wichtigste Grundsatz ist alt und bewährt: minimale Rechte. Ein Agent erhält nur die Berechtigungen, die er für genau seine Aufgabe braucht – lesend, wo Lesen genügt, und begrenzt auf die nötigen Datenbereiche.
Dazu gehört eine eigene technische Identität je Agent statt geteilter Benutzerkonten oder persönlicher Zugangsdaten von Mitarbeitenden. Nur so lassen sich Aktionen eindeutig zuordnen, Rechte gezielt entziehen und Zugriffe auswerten. Wie sich Identitäten, Netzsegmente und Cloud-Berechtigungen sauber zuschneiden lassen, gehört zur klassischen Absicherung von Zugriffen, Netzwerk und Cloud – Agenten sind hier ein weiterer, anspruchsvoller Nutzer.
Sandboxing und begrenzte Wirkung
Agenten, die Code ausführen oder Dateien verarbeiten, gehören in eine abgeschottete Umgebung (Sandbox): ohne Zugriff auf Produktivsysteme, mit eingeschränktem Netzwerkzugang und kontrollierten Ausgabewegen. Ergänzend helfen harte Grenzen außerhalb des Modells: Höchstbeträge, maximale Anzahl von Aktionen pro Zeitraum, Allowlists für erlaubte Empfänger oder Ziele.
Der Gedanke dahinter: Die Sicherheit darf nicht davon abhängen, dass das Sprachmodell sich korrekt verhält. BSI und die französische Cybersicherheitsbehörde ANSSI empfehlen in ihren gemeinsamen Designprinzipien für LLM-basierte Systeme deshalb einen Zero-Trust-Ansatz: Ausgaben und automatisierte Aktionen eines möglicherweise manipulierten Systems sollen nicht blind als vertrauenswürdig gelten. Das Papier nennt außerdem Sandboxing, minimale Rechte und die Zustimmung eines Menschen bei kritischen Aktionen.
Technische Freigaben statt Vertrauen
Folgenreiche Aktionen – Zahlungen, Löschungen, Vertragsänderungen, externe Kommunikation im Namen des Unternehmens – sollten eine technische Freigabe erfordern. Das heißt: Der Agent kann die Aktion nur vorbereiten, ausgeführt wird sie erst nach Bestätigung durch eine berechtigte Person oder nach einer deterministischen Prüfung im Backend.
Monitoring, Protokollierung und menschliche Aufsicht
Was protokolliert werden sollte
Ohne Protokolle lässt sich nicht nachvollziehen, warum ein Agent etwas getan hat. Bewährt hat sich, mindestens festzuhalten: Auftrag, verarbeitete Quellen, aufgerufene Werkzeuge mit Parametern, Ergebnis und gegebenenfalls Freigabe. Die Protokolle sollten vor Manipulation geschützt und datenschutzkonform gestaltet sein, denn sie enthalten oft personenbezogene Daten.
Auf Basis dieser Daten lassen sich Auffälligkeiten erkennen: ungewöhnlich viele Aktionen, neue Empfänger, Zugriffe außerhalb des üblichen Musters. Ein Not-Aus, mit dem sich ein Agent sofort stoppen und seine Berechtigungen entziehen lassen, gehört zur Grundausstattung.
Human-in-the-loop bei folgenreichen Aktionen
Menschliche Aufsicht ist kein Misstrauensvotum gegen die Technik, sondern eine Frage der Verantwortung. Für Hochrisiko-KI-Systeme schreibt der AI Act sie ausdrücklich vor: Betreiber müssen die menschliche Aufsicht nach Art. 26 Abs. 2 natürlichen Personen übertragen, die über die nötige Kompetenz, Ausbildung und Befugnis verfügen. Diese Pflichten gelten für Hochrisiko-Systeme nach Anhang III ab dem 2. Dezember 2027, für solche nach Anhang I ab dem 2. August 2028. Die meisten Agenten im Büroalltag sind keine Hochrisiko-Systeme. Als gute Praxis empfehle ich trotzdem, die Freigabepflicht an der Tragweite der Aktion auszurichten, nicht an der Technik. Welche Formen der Aufsicht es gibt und wie man sie praktikabel gestaltet, beschreibt der Beitrag zur menschlichen Aufsicht über KI.
Wichtig ist, dass Freigaben echt sind: Wer täglich hunderte Bestätigungen anklickt, prüft nicht mehr. Besser sind wenige, gut begründete Freigabepunkte mit verständlicher Darstellung dessen, was der Agent tun will.
Sicherheitsprüfungen und Risikobewertung vor dem Go-live
Red Teaming und Tests
Vor dem produktiven Einsatz sollte ein Agent gezielt angegriffen werden: mit manipulierten Dokumenten, widersprüchlichen Aufträgen, Versuchen, ihn zu unerlaubten Aktionen zu bewegen. Dieses „Red Teaming“ ist keine einmalige Übung. Modelle, Werkzeuge und Prompts ändern sich, also müssen auch Tests nach Änderungen wiederholt werden.
Risikobewertung je Anwendungsfall
Bevor ein Agent produktiv geschaltet wird, gehört eine dokumentierte Risikobewertung dazu. Leitfragen sind:
- Welche Aktionen kann der Agent auslösen, und was ist der schlimmste realistische Fehler?
- Welche Daten sieht er, und welche davon sind vertraulich oder personenbezogen?
- Welche fremden Inhalte verarbeitet er, die manipuliert sein könnten?
- Wer ist für den Agenten verantwortlich, und wer darf ihn stoppen?
- Gibt es Pflichten aus dem AI Act oder der DSGVO, etwa bei automatisierten Entscheidungen nach Art. 22 DSGVO?
Wie sich solche Bewertungen in einen strukturierten Prozess einbetten lassen, zeigt der Beitrag zum KI-Risikomanagement. Für Agenten mit Außenwirkung lohnt zudem ein Blick auf Ihre KI-Governance und die Anforderungen des EU AI Act, damit Zuständigkeiten und Freigabewege nicht für jeden Agenten neu erfunden werden.
Was Sie jetzt tun können
- Bestand aufnehmen: Erfassen Sie, wo bereits Agenten oder agentenähnliche Funktionen laufen – auch in Standardsoftware, Add-ins und Automatisierungsplattformen.
- Autonomiestufe festlegen: Ordnen Sie jedem Agenten eine Stufe zu und begründen Sie sie. Starten Sie im Zweifel mit „Vorschlagen“.
- Rechte zuschneiden: Eigene Identität je Agent, minimale Berechtigungen, keine geteilten Admin-Schlüssel.
- Harte Grenzen außerhalb des Modells setzen: Beträge, Mengen, Empfänger und Ziele serverseitig begrenzen.
- Freigabepunkte definieren: Folgenreiche Aktionen nur nach technischer Bestätigung.
- Protokollieren und überwachen: Werkzeugaufrufe nachvollziehbar speichern, Auffälligkeiten auswerten, Not-Aus bereithalten.
- Testen und wiederholen: Red Teaming vor dem Go-live und nach jeder wesentlichen Änderung.
Fazit
KI-Agenten können Routinearbeit spürbar entlasten. Ihr Risiko liegt weniger in der Intelligenz des Modells als im Handlungsspielraum, den man ihnen gibt. Wer Autonomie bewusst abstuft, Rechte eng zuschneidet, folgenreiche Aktionen an Freigaben knüpft und das Verhalten protokolliert, kann Agenten kontrolliert einsetzen. Vertrauen entsteht dabei nicht durch beeindruckende Demos, sondern durch nachvollziehbares und begrenzbares Verhalten im Alltag.
Quellen
- OWASP Top 10 for Agentic Applications for 2026, OWASP GenAI Security Project
- OWASP GenAI LLM Top 10 2026, OWASP GenAI Security Project
- Indirect Prompt Injections – Intrinsische Schwachstelle in anwendungsintegrierten KI-Sprachmodellen, Bundesamt für Sicherheit in der Informationstechnik
- Design Principles for LLM-based Systems with Zero Trust, ANSSI und BSI
- Agentic misalignment: How LLMs could be insider threats, Anthropic, Forschungsbericht vom 20. Juni 2025
- Artikel 26: Pflichten der Betreiber von Hochrisiko-KI-Systemen, AI Act Service Desk der Europäischen Kommission (konsolidierte Fassung)
- Artikel 113: Inkrafttreten und Geltungsbeginn, AI Act Service Desk der Europäischen Kommission
- Regulatory framework for AI, Europäische Kommission
Weitere Beiträge zum Thema
KI & KI-Governance
29. Oktober 2026
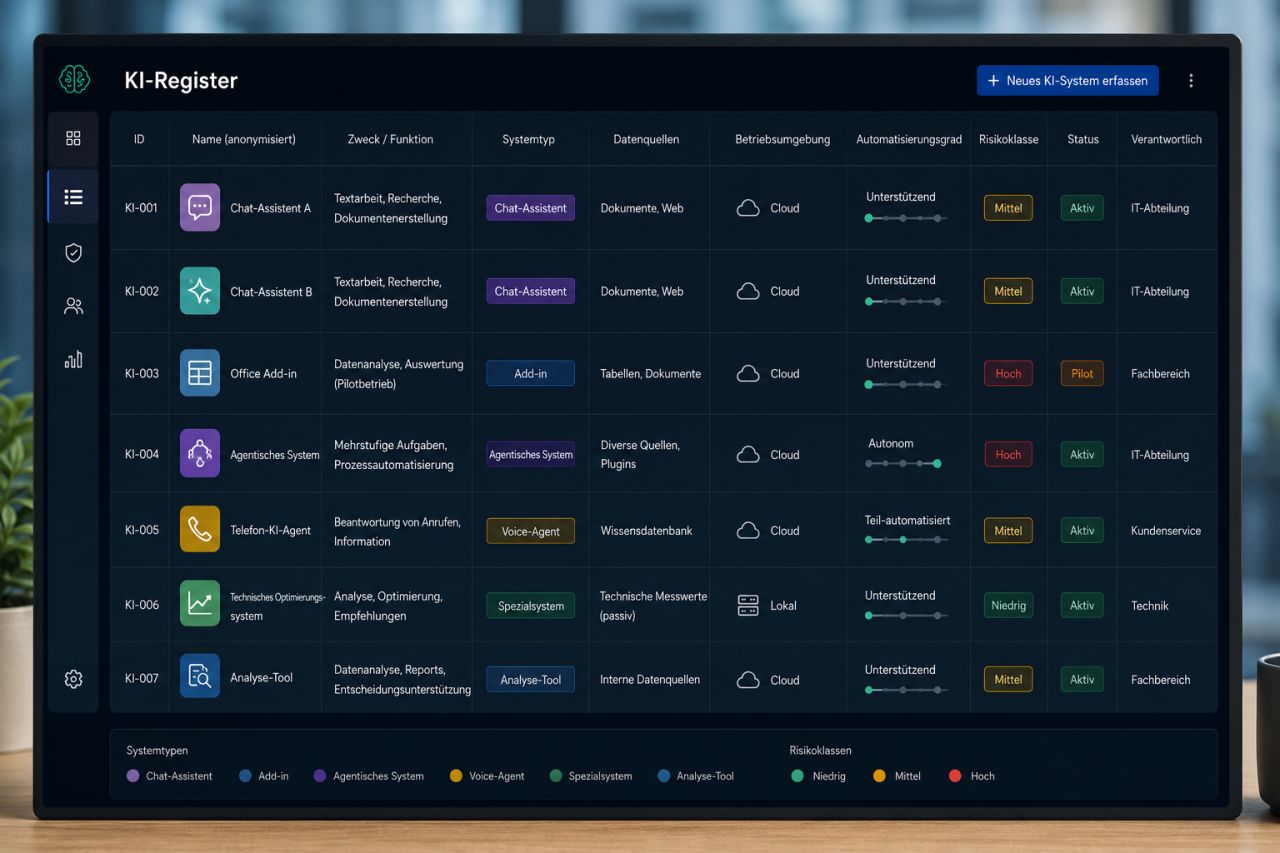
Ohne Überblick keine Steuerung: Wie Sie ein KI-Register aufbauen, welche Systeme und Datenfelder hineingehören und warum es die Grundlage für AI-Act-Pflichten und Risikomanagement ist.
KI & KI-Governance
29. Oktober 2026
Der AI Act ist Gesetz, ISO/IEC 42001 eine freiwillige Managementsystemnorm. Wie beides zusammenhängt, was EN 18286 ändert und wann ein KI-Managementsystem echten Mehrwert bringt.
KI & KI-Governance
29. Oktober 2026
IT-Betrieb, Kundenservice oder Buchhaltung sind ausgelagert, und plötzlich arbeitet dort KI mit Ihren Daten. Wie Sie Dienstleister steuern, ohne die Verantwortung aus der Hand zu geben.